System One Models und Jev: strukturierte AI-Entscheidungen für Software-Automation
Was TypeSafes System One Models und Jev für Produktteams bedeuten - typed decisions statt Chat-Strings und wo das in AI Workflow Automation passt.
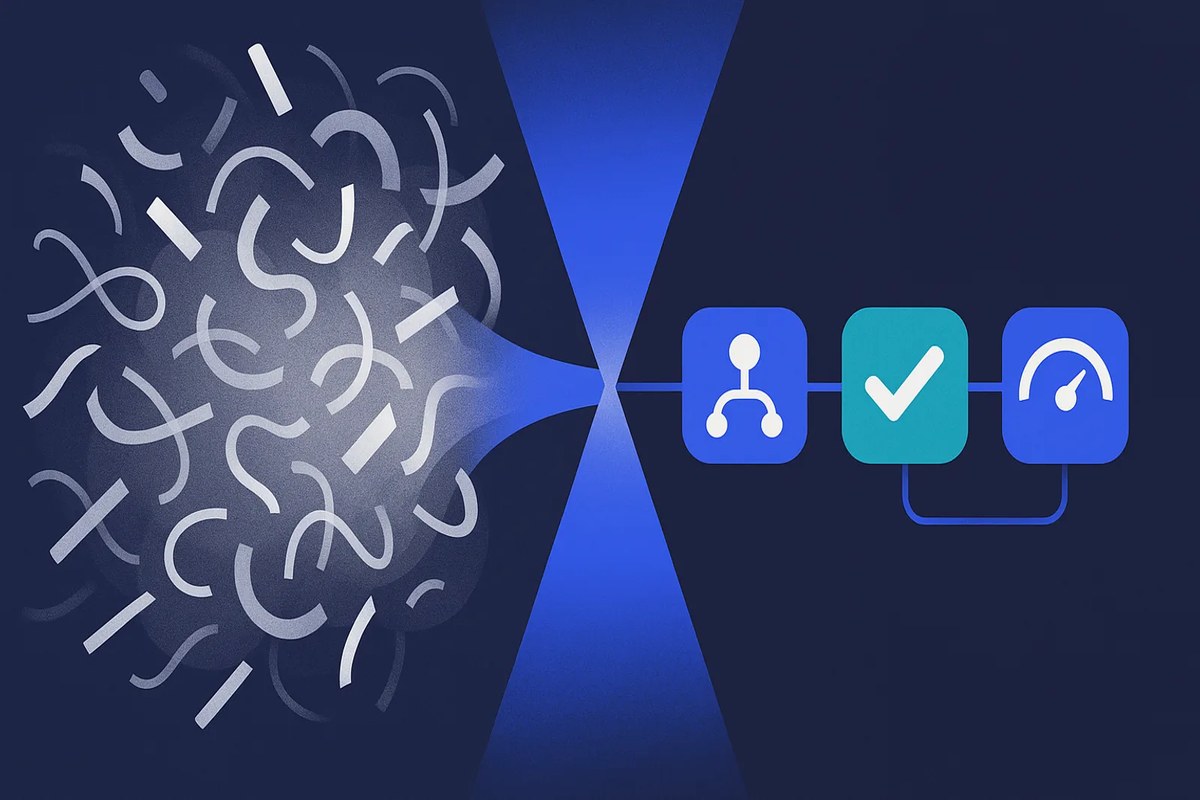
Große Sprachmodelle sind im Dialog bereits stark. Das ist nicht die zentrale Härte von AI Workflow Automation in Production. Die Härte liegt darin, ein Modell in Software einzubetten: Request-Path, Queue-Worker, Risk-Schritt - dort, wo eine Entscheidung nötig ist: schnell, schema-safe und ehrlich gegenüber Unsicherheit.
Im September 2026 hat TypeSafe AI eine neue Modellklasse System One Models und das erste öffentliche Modell Jev angekündigt. Unten: worum es in der Ankündigung geht, worin der Unterschied zu Chat-LLMs liegt und wo das nützlich ist (und wo nicht), wenn Sie Automation entwerfen - nicht Demos.
Der Artikel steht neben unserer Praxis zu AI automation und AI development und ergänzt den Ops-Winkel aus Applied AI für SMB Operations.
Welche Lücke System One schließt
Chat- und Coding-Agents bevorzugen freien Text: Absatz, Code, JSON „wie es kommt“, einen Tool Call als String. Für Menschen ist das bequem - lesen, korrigieren, nachfragen. Ein Production-Service braucht einen anderen Vertrag: nicht „schön antworten“, sondern eine Entscheidung treffen (Queue, Tarif, freigeben oder blockieren) stabil und in Millisekunden. Ein flexibler String ist dafür schlecht: man parst, validiert, fängt „fast JSON“ und retried. Für Chat erträglich; auf dem Hot Path ein Ausfall.
Typischer Schmerz, wenn ein LLM als „Entscheidungs-Engine“ in Production läuft:
- Jede Antwort parsen und validieren, dann retryen, wenn das Modell ein Feld erfindet.
- Latency in Sekunden (oder länger mit Reasoning) auf einem Pfad, der sich instant anfühlen soll.
- Confidence, der man schwer trauen kann: das Modell kann falsch liegen und das nicht sagen.
- Kosten wachsen mit Output-Tokens, obwohl nur Label und Score nötig waren.
These von TypeSafe: Automation braucht eine andere Schnittstelle - unstrukturierter State rein, typed probabilistic decisions raus. Diese Klasse nennen sie System One Models, und Jev ist das erste Early-Access-Modell.
Was System One Models sind
Der Name verweist auf Daniel Kahneman und Thinking, Fast and Slow: schnelles System 1 vs. langsames System 2. Die Produktwette ist nicht „eine Chat-Modell schneller machen“, sondern ein Stack von Entscheidungen, die Software wie eine Funktion aufruft.
| Dimension | Typisches Frontier-LLM | System One (Jev, laut TypeSafe) |
|---|---|---|
| Trainingsfokus | Preferences / verifiable text (RLHF, RLVR-style) | Calibrated decisions (RLCD in ihrer Terminologie) |
| Inputs | Messages und Text | Unstrukturierte Daten mit Fokus auf structured program state |
| Outputs | Generierte Strings (Parsing nötig) | Vorab definierte type-safe structured values |
| Sampling | Sequenzielle Tokens | Parallele Outputs in einer Anfrage |
| Confidence | Oft overconfident, wenn man fragt | Kalibrierte Wahrscheinlichkeiten mit der Antwort |
| „Form“ der Antwort | Kann „schwimmen“ | Schema-Match als Garantie beansprucht (keine Free-String-Generation) |
Kurz: Jev wird als frontier-intelligence function call positioniert, nicht als Chatbot. Das Modell verzichtet auf offene Prosa, damit Software auf Struktur, Geschwindigkeit und Unsicherheitsschätzung bauen kann.
Vendor-Zahlen (Speed, Cost, Evals) werden sich ändern. Launch-Metriken sind Claims zur Prüfung in Ihrem Harness - kein SLA. Für die Architektur zählt die Shape des Produkts: Entscheidungen mit Typen und Wahrscheinlichkeiten, keine Essays.
Wo Jev nützlich ist
Modelle der Klasse Jev passen dort, wo die Aufgabe classify, route, score, extract oder branch ist - und der Workflow Ihrem Code gehört.
1. Clevere Ifs und Router
Handgeschriebene Regeln brechen an schmutzigem Text, Tickets und gemischten CRM-Feldern. Ein Typed-Decision-Model sitzt im normalen Code als Fuzzy-Regel: Queue, Severity, nächsten Schritt wählen - mit Confidence-Schwelle und Eskalation an Menschen.
Denselben Layer ziehen viele Teams heute auf LLM + JSON Mode und verbrennen danach Engineering an Retries und Schema-Drift.
2. Workflow-Schritte mit probabilistischem Branching
Echte Geschäftsprozesse brauchen selten einen riesigen „Agent Thought“. Sie brauchen viele kleine unabhängige Fragen, deren Antworten sich zusammensetzen: Risk Band, Dokumentenvollständigkeit, Sprache, Intent, Eligibility. TypeSafes Narrative dreht sich genau um Dekomposition und probability-aware Verhalten in einem festen Compute Graph, den Sie besitzen.
Das liegt nah an intelligent process automation: der Graph ist Ihrer; das Modell füllt die Fuzzy-Knoten.
3. Real-time-Pfade im Produkt
Sitzt ein AI-Call auf einem user-facing Critical Path (Checkout-Assist, In-App-Routing, Live-Moderation), sind mehrsekündige LLM-Turns eine UX-Steuer. Modelle mit Latency im Bereich von Zig bis Hunderten Millisekunden ändern, was sich automatisieren lässt, ohne den Nutzer warten zu lassen.
4. Map-Reduce über große Korpora
Wenn aus Dokumenten oder Events Features und Labels entstehen sollen, schlagen parallele structured decisions Chatbot-Schleifen. Cost und Throughput dominieren, nicht Essay-Qualität.
5. Guardrails und Verifikation um andere LLMs
Praktisches Muster: Chat- oder Coding-Model erzeugt freien Text, dann bewertet ein Decision Model Jailbreak, Policy Breach, Schema Compliance oder „ist die Antwort grounded?“. TypeSafe nennt explizit verify / judge / guardrail. Für Teams, die LLMs nicht wegwerfen, aber eine günstige, schnelle zweite Meinung in der Pipeline wollen.
Wo man es nicht einsetzen sollte
Ziehen Sie System One / Jev nicht auf Aufgaben offener Generierung:
- Customer-facing Chat mit nuancierteren Antworten.
- Coding Agents, die Patches und Erklärungen schreiben.
- Kreativarbeit und Research, bei denen das Deliverable Text ist.
- Jede Aufgabe, bei der sich das Output-Schema nicht vorab festlegen lässt.
Vorsicht bei regulierten Entscheidungen (Credit / Insurance / Healthcare). Kalibrierte Wahrscheinlichkeiten helfen der Engineering-Seite, ersetzen aber weder Policy noch Explainability noch menschliche Verantwortung. Eine Modellklasse ist kein Compliance-Zertifikat.
Ist die Aufgabe noch „wir brauchen einen Prototyp, der im Demo manchmal funktioniert“, ist ein flexibles LLM schneller. System One ist für den Fall, dass Automation laufen muss.
Wie Produktteams über den Stack denken sollten
Ein robustes Applied-AI-Muster in Software:
- Den Workflow im Code besitzen (States, Retries, Audit Log, wer override darf).
- LLM nutzen, wo das Produkt Generation oder Tool Orchestration ist.
- Typed decision models (Jev-Klasse oder constrained Classifiers) nutzen, wo Branch, Score oder Label nötig sind.
- Nach Confidence gaten: unter der Schwelle → Mensch oder Regeln; nie silent fail.
Das ist das Gegenteil von „ERP durch einen Agent ersetzen“. Es liegt näher daran, wie Ops-Automation wirklich shippt: siehe Applied AI für SMB Operations.
Vergleichen Sie custom AI agents vs. Workflow Automation, zählt selten die „Modellmarke“. Zählt das Interface auf jedem Schritt: Prosa-Generation, Tool Calling oder typed decision mit Wahrscheinlichkeit.
Was das für Smartym-Kunden bedeutet
Für Teams, die wir bei AI automation und custom AI development begleiten, sind Ankündigungen wie Jev ein Design-Signal, kein verpflichtender Vendor Pick:
- Bevorzugen Sie schema-first Automation-Design, auch wenn Sie heute noch ein LLM aufrufen.
- Trennen Sie im Architecture Review generation und decision.
- Messen Sie Latency, Cost per Decision und Error Rate auf einem festen Workflow-Harness (nicht nur Chatbot-Quality-Scores).
- Pilotieren Sie High-Volume-, Low-Regret-Zweige vor Hot-Path Money Movement und irreversiblen Aktionen.
Wir endorsen keinen konkreten Early-Access-Vendor. Wir endorsen das Engineering-Prinzip: software-native AI-Interfaces schlagen Chat, der in Production geklebt wurde.
Wichtige Takeaways
- System One Models (TypeSafe-Framing) sind schnelle, strukturierte, kalibrierte Entscheidungen für Code, nicht für Chat.
- Jev ist ihr erstes öffentliches Modell dieser Klasse: typed outputs, parallel sampling, by design ohne Free-String-Generation.
- Nutzen für Routing, Scoring, Classification, Map-Reduce-Labelling und Guardrails um LLMs.
- Vermeiden für offene Textgenerierung, Coding Agents und undefinierte Schemas.
- Architektur gewinnt trotzdem: Ihr Workflow im Code, Modelle als austauschbare Decision Nodes.
Wenn Sie klären, welche Schritte im Produkt- oder Ops-Stack Regeln bleiben, welche an ein LLM gehen und welche an typed AI decisions, erzählen Sie uns von Ihrem Workflow - wir helfen, einen Pilot mit Throughput- und Error-Rate-Metriken zu designen, nicht mit Demo-Screenshots.